Como um dos principais algoritmos de Machine Learning pode transformar dados de partidas em modelos probabilísticos
Quando falamos em Machine Learning aplicado às apostas esportivas, é comum pensar imediatamente em redes neurais.
Mas existe uma família de algoritmos que pode ser extremamente poderosa quando trabalhamos com dados estruturados, como os encontrados em planilhas de partidas de futebol.
É o Gradient Boosting.
Algoritmos baseados nessa técnica, como XGBoost, LightGBM e CatBoost, são amplamente utilizados em problemas de classificação e regressão.
No contexto esportivo, podem ser utilizados para estimar probabilidades de acontecimentos como:
- vitória do mandante;
- empate;
- vitória do visitante;
- Over 1.5;
- Over 2.5;
- ambas marcam;
- gol no primeiro tempo;
- gol até determinado minuto;
- ou qualquer outro evento que possa ser transformado em uma variável de interesse.
Mas como esse algoritmo funciona?
E por que ele pode ser tão interessante para dados esportivos?
O que é Gradient Boosting?
Para entender Gradient Boosting, primeiro precisamos entender uma ideia mais simples:
árvores de decisão.
Uma árvore de decisão tenta dividir os dados através de perguntas sucessivas.
Por exemplo:
O xG do mandante é maior que 1,50?
Se sim, seguimos por um caminho.
Se não, seguimos por outro.
Depois:
A equipe marcou mais de 1,5 gol por jogo?
E assim sucessivamente.
No final, chegamos a uma estimativa.
Uma única árvore, porém, pode cometer muitos erros.
O Gradient Boosting utiliza uma estratégia diferente.
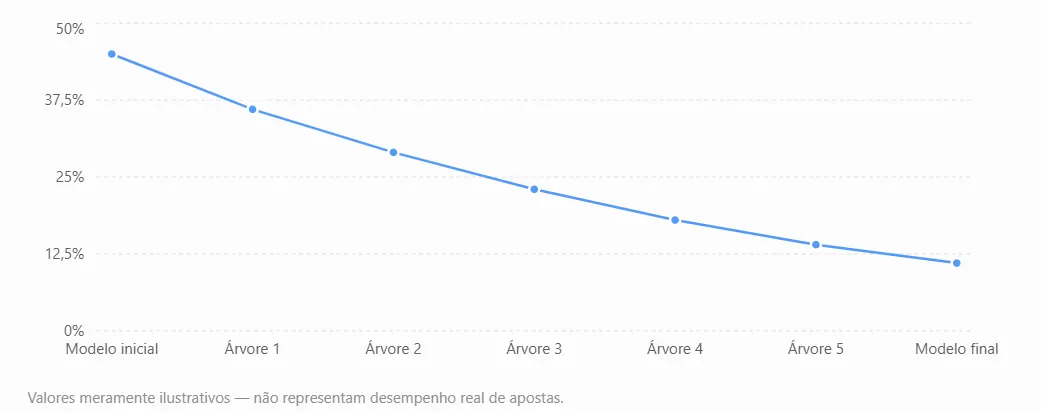
Em vez de criar apenas uma árvore extremamente complexa, ele constrói várias árvores sequencialmente, fazendo com que cada nova árvore tente corrigir os erros cometidos pelas anteriores.
A ideia central pode ser resumida assim:
Árvore 1 → identifica padrões
Árvore 2 → corrige erros da Árvore 1
Árvore 3 → corrige erros anteriores
Árvore 4 → continua refinando o modelo
E assim por diante.
O resultado final é a combinação de muitas árvores relativamente simples.
Código Python para Gradiente Boosting
Na linguagem Python, esse seria um código para GB:
Python
Por que o nome “Boosting”?
A palavra boosting pode ser entendida como “impulsionar” ou “fortalecer”.
A ideia é combinar vários modelos mais simples para construir um modelo mais poderoso.
Imagine que temos uma série de pequenos analistas.
- O primeiro faz uma estimativa.
- Depois identificamos onde ele errou.
- O segundo analista recebe essa informação e tenta melhorar justamente esses pontos.
- Depois entra um terceiro.
- E um quarto.
Cada novo modelo acrescenta uma pequena melhoria.
Ao final, temos um sistema muito mais sofisticado do que qualquer um dos modelos isoladamente.
Essa é a lógica fundamental do boosting.
E onde entra o “Gradient”?
O termo gradient está relacionado à forma como o algoritmo procura reduzir o erro.
O modelo utiliza uma função de perda (loss function) para medir o quanto suas previsões estão distantes dos resultados observados.
Depois, o algoritmo procura uma direção que reduza esse erro.
A cada etapa, uma nova árvore é construída para ajudar a minimizar a função de perda.
De maneira simplificada:
Previsão inicial
↓
Medição do erro
↓
Nova árvore para reduzir o erro
↓
Atualização do modelo
↓
Nova medição do erro
↓
Nova árvore
↓
Modelo final
É um processo iterativo de aperfeiçoamento.
Um exemplo no futebol
Imagine que queremos prever:
Houve Over 0.5 gol no primeiro tempo?
Nossa base contém milhares de partidas.
Para cada jogo, podemos ter:
- média de gols do mandante;
- média de gols do visitante;
- média de gols no primeiro tempo;
- xG;
- finalizações;
- desempenho em casa;
- desempenho fora;
- frequência histórica de Over 0.5 HT;
- força das equipes;
- média de gols do campeonato.
O modelo começa com uma estimativa inicial.
Depois compara suas previsões com os resultados reais.
Imagine que algumas partidas foram classificadas incorretamente.
A próxima árvore tenta encontrar padrões nos erros.
Talvez ela identifique que o modelo está subestimando jogos em que:
- o mandante apresenta xG elevado;
- o visitante sofre muitos gols fora;
- e a média de gols da competição é alta.
A nova árvore acrescenta informação ao modelo.
Outra árvore poderá encontrar outro padrão.
Depois outra.
O resultado é um conjunto de árvores que trabalham em conjunto.
Gradient Boosting aprende com os próprios erros
Essa é provavelmente a maneira mais simples de entender o conceito.
Imagine que um modelo produza estas previsões:
Jogo A → 70%
Jogo B → 65%
Jogo C → 30%
Jogo D → 80%
Depois descobrimos que algumas dessas previsões estavam muito distantes do resultado real.
O algoritmo não simplesmente ignora esses erros.
Eles ajudam a determinar o que o próximo modelo deve tentar corrigir.
Assim, cada etapa acrescenta uma pequena melhoria.
Isso é diferente de simplesmente treinar centenas de árvores independentes e fazer uma média.
No Gradient Boosting, existe uma sequência de aprendizado.
Cada etapa depende das anteriores.
Gradient Boosting x Random Forest
Os dois métodos utilizam árvores de decisão, mas funcionam de maneira diferente.
No Random Forest, diversas árvores são construídas de maneira relativamente independente e suas previsões são combinadas.
No Gradient Boosting, as árvores são construídas sequencialmente.
Cada nova árvore tenta melhorar o modelo existente.
Podemos pensar assim:
Random Forest
Árvore + Árvore + Árvore + Árvore → combinação
Gradient Boosting
Árvore → correção → nova árvore → correção → nova árvore → modelo final
Essa diferença faz com que o Gradient Boosting seja particularmente interessante para problemas em que pequenas melhorias sucessivas podem produzir um modelo muito poderoso.
Por que isso é interessante para apostas esportivas?
Grande parte dos dados esportivos possui estrutura tabular.
Imagine uma planilha com milhares de partidas e dezenas de colunas:
| Jogo | xG Casa | xG Fora | Gols Casa | Gols Fora | Finalizações | Over 1.5 |
|---|
| 1 | 1,80 | 0,90 | 2 | 0 | 14 | Sim |
| 2 | 1,10 | 1,60 | 0 | 2 | 11 | Sim |
| 3 | 0,85 | 0,70 | 0 | 0 | 7 | Não |
Esse tipo de dado é justamente o ambiente em que algoritmos de boosting podem ser bastante interessantes.
Eles conseguem trabalhar com:
- variáveis numéricas;
- variáveis categóricas, dependendo da implementação;
- relações não lineares;
- interações entre variáveis;
- diferentes escalas de informação.
E não exigem necessariamente que o analista estabeleça antecipadamente todas as relações matemáticas entre as variáveis.
O modelo não precisa saber a “fórmula do futebol”
Essa é uma das características interessantes do Machine Learning.
Em um modelo tradicional, podemos estabelecer uma estrutura matemática para explicar determinado fenômeno.
No Gradient Boosting, fornecemos os dados e o resultado que queremos estudar.
O algoritmo procura relações úteis.
Por exemplo:
xG elevado + defesa adversária vulnerável + forte desempenho em casa
pode produzir uma probabilidade maior de determinado evento.
Mas o modelo não precisa receber essa regra pronta.
Ele pode aprender uma combinação semelhante a partir dos dados.
Isso permite capturar relações que seriam difíceis de especificar manualmente.
Feature Engineering continua sendo importante
O fato de o Gradient Boosting conseguir encontrar padrões não significa que podemos jogar qualquer informação dentro dele.
A qualidade das variáveis continua sendo fundamental.
Imagine que queremos prever o desempenho de uma equipe.
Podemos utilizar:
Forma recente
- gols nos últimos 5 jogos;
- xG nos últimos 5 jogos;
- finalizações nos últimos 5 jogos.
Desempenho como mandante
- gols marcados em casa;
- gols sofridos em casa;
- xG em casa.
Desempenho do visitante
- gols marcados fora;
- gols sofridos fora;
- xG fora.
Força relativa
- diferença de Elo;
- posição na tabela;
- diferença de pontos;
- desempenho contra adversários semelhantes.
Essas variáveis podem oferecer ao algoritmo diferentes formas de interpretar o confronto.
Mas existe uma armadilha: vazamento de dados
Um dos erros mais perigosos em Machine Learning esportivo é utilizar informações que não estavam disponíveis no momento da previsão.
Imagine que queremos prever um jogo da 10ª rodada.
Não podemos calcular a média da temporada utilizando também os jogos da 11ª, 12ª, 13ª e demais rodadas.
Isso seria utilizar informação do futuro.
O modelo pareceria extremamente eficiente.
Mas estaria trapaceando sem perceber.
Por isso, todas as variáveis precisam respeitar uma regra:
somente informações disponíveis antes do evento podem ser utilizadas para prevê-lo.
Esse cuidado é ainda mais importante quando trabalhamos com estatísticas acumuladas ao longo da temporada.
O problema do overfitting
Gradient Boosting pode produzir modelos extremamente poderosos.
E justamente por isso existe um risco:
overfitting.
Se permitirmos que o algoritmo crie árvores muito complexas e faça muitas iterações, ele pode começar a aprender detalhes específicos da amostra de treinamento.
O modelo passa a explicar muito bem o passado.
Mas pode perder capacidade de generalização.
No futebol, isso é especialmente perigoso.
Um modelo pode encontrar uma relação extremamente específica em uma determinada liga, temporada ou conjunto de partidas que simplesmente não se repete.
Por isso, controlar a complexidade do modelo é fundamental.
Learning Rate e número de árvores
Dois conceitos importantes no Gradient Boosting são:
Learning Rate
Controla o tamanho da contribuição de cada nova árvore.
Um learning rate menor significa que cada árvore acrescenta uma contribuição menor ao modelo.
Isso geralmente exige mais árvores.
Número de estimadores
Representa, de forma simplificada, quantas árvores serão adicionadas ao modelo.
Existe uma relação importante entre os dois.
Por exemplo:
Learning rate alto + poucas árvores
ou
Learning rate baixo + muitas árvores
Podem produzir modelos com comportamentos muito diferentes.
O objetivo é encontrar uma combinação que ofereça bom desempenho sem gerar overfitting.
XGBoost, LightGBM e CatBoost
Quando falamos em Gradient Boosting, encontramos diferentes implementações.
Entre as mais conhecidas estão:
XGBoost
Uma das implementações mais populares de Gradient Boosting.
É conhecida pela eficiência e pelo desempenho em dados tabulares.
LightGBM
Desenvolvida para trabalhar de maneira eficiente com grandes conjuntos de dados.
Pode ser especialmente interessante quando temos muitas observações e variáveis.
CatBoost
Possui recursos particularmente úteis para trabalhar com variáveis categóricas.
A escolha entre elas depende do problema, dos dados e da configuração do projeto.
Não existe uma implementação universalmente melhor.
O modelo deve produzir probabilidades
No contexto das apostas esportivas, uma característica especialmente interessante é utilizar o algoritmo para produzir probabilidades, e não apenas classificações.
Imagine:
Over 0.5 HT → 71%
O modelo está dizendo que, para uma partida com determinadas características, estima uma probabilidade de aproximadamente 71% para o evento.
Essa informação pode ser transformada em uma estimativa de odd justa:
1 ÷ 0,71 ≈ 1,41
A partir daí, podemos comparar essa estimativa com a cotação do mercado.
Isso cria uma ponte entre:
Machine Learning → Probabilidade → Preço → Análise de valor
Mas ainda falta uma parte essencial:
verificar se as probabilidades são boas.
A importância da calibração
Imagine que um modelo produza 1.000 previsões classificadas como 70%.
Se o modelo estiver bem calibrado, esperamos que aproximadamente 70% desses eventos aconteçam.
Se, na realidade, apenas 55% acontecerem, o modelo está superestimando suas probabilidades.
Se 85% acontecerem, está subestimando.
Por isso, avaliar apenas a acurácia não é suficiente.
Para um modelo utilizado em decisões baseadas em probabilidade, calibração é fundamental.
Um bom modelo não precisa acertar todos os jogos.
Ele precisa produzir probabilidades que tenham significado estatístico.
Backtesting: o teste do passado
Depois que o modelo é construído, podemos realizar um backtest.
A ideia é verificar como ele teria se comportado em dados históricos.
Mas existe uma diferença importante entre:
“O modelo funciona no histórico.”
e
“O modelo funciona em dados que não participaram do desenvolvimento.”
O segundo cenário é muito mais importante.
Se ajustarmos repetidamente o modelo até encontrar a melhor configuração para determinado período histórico, podemos simplesmente estar adaptando o algoritmo ao passado.
Por isso, é importante reservar dados para um teste final.
Validação temporal
Em esportes, uma abordagem interessante é utilizar validação respeitando a ordem cronológica.
Por exemplo:
Treinamento: 2019–2022
Validação: 2023
Teste: 2024
Depois podemos avançar a janela:
Treinamento: 2019–2023
Validação: 2024
Teste: 2025
Essa abordagem permite observar como o modelo se comporta quando o ambiente muda ao longo do tempo.
É uma forma mais realista de testar um sistema que pretende fazer previsões futuras.
Machine Learning não é sinônimo de lucro
Esse ponto precisa ser repetido.
Um modelo com excelente desempenho estatístico não necessariamente produzirá lucro.
Existe uma diferença entre:
prever melhor
e
encontrar valor no mercado.
O mercado possui preços.
Se o modelo estima 55% de probabilidade e a cotação disponível já corresponde aproximadamente a essa probabilidade, talvez não exista vantagem suficiente.
Por isso, o problema completo envolve pelo menos três elementos:
Probabilidade estimada
Probabilidade implícita no preço
Diferença entre as duas
O algoritmo é apenas uma parte dessa equação.
E se o modelo encontrar uma vantagem?
Mesmo nesse cenário, precisamos perguntar:
Essa vantagem é real ou resultado de variância?
Para responder, precisamos de:
- amostras suficientemente grandes;
- testes fora da amostra;
- validação temporal;
- controle de overfitting;
- métricas estatísticas;
- análise de calibração;
- estabilidade em diferentes períodos;
- comparação com modelos mais simples.
Se uma suposta vantagem desaparece quando mudamos o período ou o conjunto de dados, existe uma boa possibilidade de que ela não seja robusta.
O modelo mais simples pode vencer
Existe uma tendência de acreditar que o algoritmo mais sofisticado será necessariamente o melhor.
Não é verdade.
Imagine três modelos:
Poisson
Regressão logística
Gradient Boosting
Se o Gradient Boosting produzir uma melhoria mínima sobre a regressão logística, mas for muito mais complexo e mais difícil de interpretar, talvez a diferença não justifique a complexidade adicional.
Modelagem não é uma competição para descobrir o algoritmo mais sofisticado.
O objetivo é encontrar um modelo que ofereça boa capacidade preditiva, estabilidade e generalização.
Um projeto de Gradient Boosting do zero
Podemos imaginar um projeto seguindo estas etapas:
1. Definir o alvo
Exemplo:
Over 0.5 gol no primeiro tempo.
2. Criar a base
Coletar milhares de partidas históricas.
3. Criar as features
Adicionar estatísticas disponíveis antes de cada jogo.
4. Separar os dados
Utilizar uma divisão temporal entre treinamento, validação e teste.
5. Treinar o modelo
Utilizar Gradient Boosting.
6. Ajustar hiperparâmetros
Testar learning rate, profundidade das árvores, número de estimadores e outros parâmetros.
7. Avaliar
Medir métricas como Log Loss, Brier Score, acurácia e calibração.
8. Fazer o teste fora da amostra
Avaliar o modelo em partidas que não participaram do desenvolvimento.
9. Comparar
Colocar o Gradient Boosting frente a modelos mais simples.
10. Monitorar
Continuar acompanhando o desempenho conforme novos jogos aparecem.
Essa estrutura é muito mais importante do que simplesmente escolher “XGBoost” e apertar o botão de treinamento.
O que o Gradient Boosting realmente oferece?
A principal vantagem não é prever o futuro com precisão absoluta.
É sua capacidade de encontrar relações complexas em dados estruturados.
Em uma base esportiva, diferentes variáveis podem interagir de maneiras difíceis de modelar manualmente.
O Gradient Boosting consegue explorar essas interações.
Isso faz dele uma ferramenta interessante para quem trabalha com grandes bancos de dados de partidas.
Mas existe uma condição:
o padrão encontrado precisa continuar existindo fora da amostra utilizada no treinamento.
Caso contrário, temos apenas um modelo que explica o passado.
Conclusão
O Gradient Boosting é uma das técnicas mais interessantes do Machine Learning para trabalhar com dados esportivos estruturados.
Seu princípio é relativamente simples:
construir modelos sequencialmente, fazendo com que cada nova etapa tente corrigir os erros das anteriores.
A partir dessa ideia, algoritmos como XGBoost, LightGBM e CatBoost conseguem construir modelos bastante sofisticados.
Nas apostas esportivas, eles podem ser utilizados para transformar informações sobre partidas em estimativas de probabilidade.
Mas o algoritmo, sozinho, não resolve o problema.
É necessário ter dados confiáveis, evitar vazamento de informação, controlar overfitting, validar o modelo fora da amostra e verificar se suas probabilidades são bem calibradas.
No final, a pergunta mais importante continua sendo a mesma:
O modelo aprendeu um padrão real ou apenas encontrou uma maneira sofisticada de explicar o passado?
É essa diferença que separa um experimento interessante de um modelo realmente útil.
E talvez seja justamente por isso que o Gradient Boosting seja tão interessante para o estudo das apostas esportivas: ele não oferece uma resposta mágica.
Ele oferece uma maneira poderosa de fazer perguntas melhores aos dados.