E se, em vez de depender de uma única previsão, um modelo analisasse centenas de árvores de decisão e combinasse todas as respostas? É essa a ideia por trás do Random Forest.
Quando falamos em modelagem estatística aplicada ao futebol, técnicas como Poisson, regressão logística, Monte Carlo e redes neurais aparecem com frequência.
O Random Forest é outra ferramenta que pode ser utilizada para transformar dados históricos em estimativas de probabilidade.
Mas como isso funciona na prática?
O que é Random Forest?
Random Forest, ou Floresta Aleatória, é um algoritmo de machine learning baseado em várias árvores de decisão.
Em vez de construir uma única árvore para tomar uma decisão, o modelo cria diversas árvores e combina seus resultados.
Imagine que queremos estimar:
O time da casa vencerá?
Uma árvore pode analisar:
- força ofensiva;
- força defensiva;
- mando de campo;
- desempenho recente;
- xG;
- posição na tabela.
Outra pode dar mais importância a:
- gols marcados;
- gols sofridos;
- desempenho como mandante;
- força do adversário.
Uma terceira pode encontrar outra combinação.
No final, o Random Forest combina as respostas dessas árvores para produzir uma estimativa.
Como funciona uma árvore de decisão?
Antes de entender a floresta, precisamos entender a árvore.
Imagine uma sequência de perguntas:
Time da casa tem xG > 1,5?
↓
SIM
↓
Adversário tem xG < 1,2?
↓
SIM
↓
Mandante venceu mais de 60% dos últimos jogos?
↓
SIM
↓
Probabilidade de vitória: 68%
Essa é uma representação simplificada de uma árvore de decisão.
Ela divide os dados em diferentes caminhos até chegar a uma classificação ou estimativa.
O problema é que uma única árvore pode ficar excessivamente adaptada aos dados utilizados no treinamento.
É aí que entra o Random Forest.
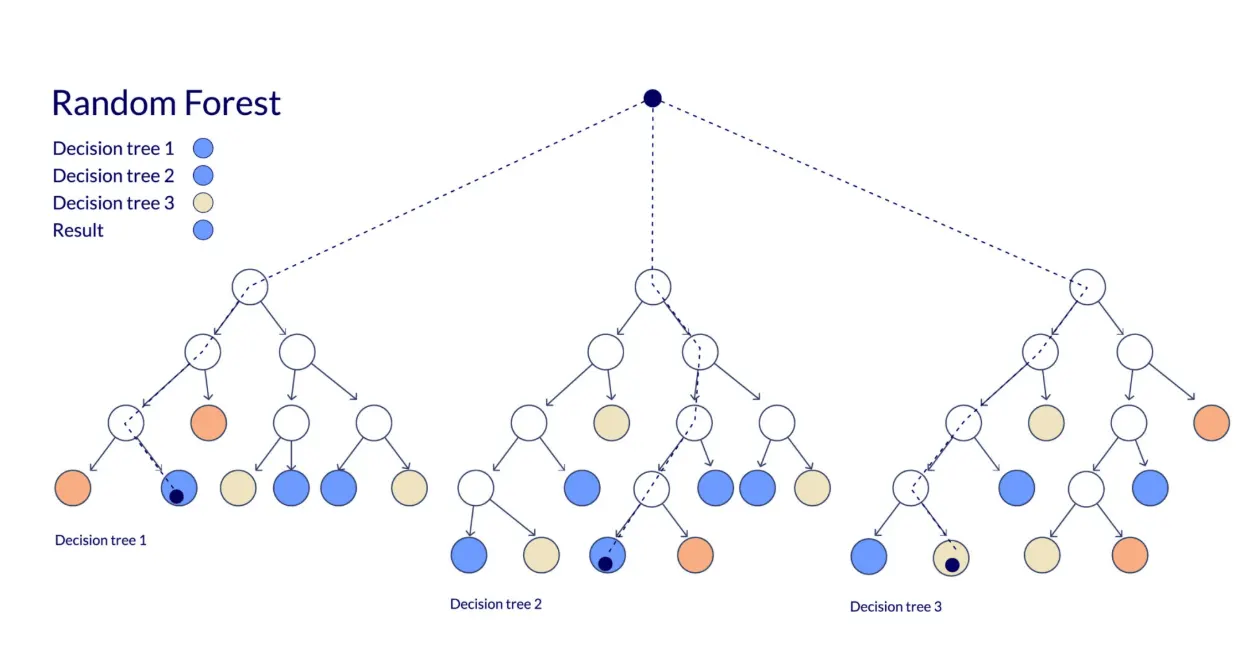
Por que várias árvores?
Imagine que você peça a opinião de um único analista sobre uma partida.
Ele pode errar.
Agora imagine consultar:
100 analistas independentes.
Cada um utiliza pequenas diferenças nos dados e nos padrões encontrados.
Se a maioria chegar a uma conclusão semelhante, você terá uma estimativa mais robusta.
O Random Forest funciona de maneira parecida.
Ele cria várias árvores utilizando diferentes amostras dos dados e diferentes subconjuntos de variáveis.
Depois combina os resultados.
Um exemplo no futebol
Imagine que você tenha uma base com 12.000 partidas.
Para cada jogo, existem informações como:
- mandante;
- visitante;
- gols marcados;
- gols sofridos;
- xG;
- finalizações;
- desempenho recente;
- mando de campo;
- posição na tabela;
- odds.
Você quer prever:
Over 2.5 gols
O modelo recebe essas informações e aprende relações existentes nos dados históricos.
Depois de treinado, pode receber uma nova partida:
Time A x Time B
E retornar:
Probabilidade de Over 2.5 = 61%
A partir dessa estimativa, podemos calcular a odd justa:
1 ÷ 0,61 = 1,64
Se o mercado estiver oferecendo uma odd maior, existe uma situação que merece ser investigada.
Random Forest não prevê a odd
Esse é um ponto importante.
O Random Forest pode ser utilizado para estimar a probabilidade de um evento.
Por exemplo:
Vitória do mandante = 58%
A partir disso, podemos calcular:
Odd justa = 1 ÷ 0,58 = 1,72
A comparação com a odd de mercado acontece depois.
Portanto, podemos pensar no processo como:
Dados → Random Forest → Probabilidade → Odd justa → Mercado → EV
Onde o Random Forest pode ser usado?
O algoritmo pode ser aplicado a diferentes mercados.
Resultado final
Estimar:
- vitória do mandante;
- empate;
- vitória do visitante.
Over/Under
Por exemplo:
Over 2.5 = 57%
Ambas Marcam
BTTS = 64%
Gol no primeiro tempo
Over 0.5 HT = 72%
Outros eventos
Dependendo dos dados disponíveis, também é possível modelar:
- cartões;
- escanteios;
- gols de determinada equipe;
- handicap;
- resultado combinado.
A qualidade do modelo dependerá principalmente dos dados utilizados e da forma como o problema foi estruturado.
Random Forest e probabilidades
Uma das grandes vantagens para aplicações em apostas é que o modelo pode produzir probabilidades, e não apenas uma resposta binária.
Em vez de:
Over 2.5 = SIM
podemos ter:
Over 2.5 = 63%
Isso permite calcular uma odd justa.
Se:
P = 63%
então:
Odd justa = 1 ÷ 0,63 = 1,59
Agora podemos comparar com o mercado.
Se a odd for:
1,50
o preço está abaixo da odd justa estimada.
Se for:
1,80
a situação é diferente.
Essa comparação é muito mais interessante do que simplesmente tentar aumentar a taxa de acerto.
E o Expected Value?
O Random Forest pode ser uma ferramenta para chegar ao EV, mas não calcula valor sozinho.
Imagine:
Probabilidade do modelo = 60%
Odd de mercado = 2,00
O EV simplificado seria:
EV = (0,60 × 2,00) − 1
EV = +0,20
Ou:
+20%
Isso significa que, se a probabilidade estimada pelo modelo for correta, a cotação apresenta valor esperado positivo.
Esse “se” é fundamental.
O problema: o modelo pode estar errado
Um Random Forest pode encontrar padrões muito interessantes nos dados históricos.
Mas isso não significa que esses padrões continuarão existindo.
Imagine que o modelo tenha identificado:
Probabilidade de 65%
O verdadeiro valor pode estar muito abaixo disso.
Se o modelo superestimar probabilidades, os cálculos de EV também serão superestimados.
Por isso, o objetivo não é construir um modelo que pareça impressionante.
É construir um modelo que generalize bem para dados novos.
Overfitting
Esse é um dos maiores riscos.
O modelo pode aprender detalhes específicos da amostra histórica que não representam uma relação verdadeira.
Imagine:
Base histórica → 12.000 jogos
O Random Forest encontra combinações extremamente específicas entre as variáveis.
No histórico:
ROI = +18%
Quando aplicado a jogos novos:
ROI = -2%
O modelo se ajustou demais ao passado.
Isso é overfitting.
Como evitar o overfitting?
Existem várias estratégias.
Dividir os dados
Separar dados de:
- treinamento;
- validação;
- teste.
Controlar a complexidade
Parâmetros como:
- profundidade máxima das árvores;
- número mínimo de observações por folha;
- número de árvores;
podem ser ajustados para reduzir o excesso de complexidade.
Testar fora da amostra
O modelo precisa ser avaliado em dados que não participaram do treinamento.
Respeitar o tempo
No futebol, esse ponto é especialmente importante.
Um modelo que tenta prever jogos de 2025 não deveria utilizar informações que só ficaram disponíveis em 2026.
A importância da seleção de variáveis
Imagine colocar 100 variáveis no modelo.
Mais informação parece melhor.
Mas algumas variáveis podem ser:
- irrelevantes;
- redundantes;
- altamente correlacionadas;
- disponíveis apenas depois do jogo;
- relacionadas indiretamente ao resultado.
Um modelo de qualidade precisa utilizar informações que realmente estejam disponíveis no momento em que a decisão seria tomada.
Isso evita um dos erros mais perigosos da modelagem:
vazamento de informação (data leakage).
Random Forest x Poisson
Os dois modelos podem ser utilizados no futebol, mas possuem características diferentes.
| Característica | Poisson | Random Forest |
|---|
| Estrutura | Distribuição estatística | Machine learning |
| Foco clássico | Gols | Classificação/regressão |
| Relações não lineares | Limitadas | Mais flexíveis |
| Interpretabilidade | Alta | Moderada |
| Necessidade de dados | Menor | Geralmente maior |
| Complexidade | Menor | Maior |
Poisson possui uma estrutura matemática muito útil para modelar gols.
Random Forest é mais flexível para encontrar relações complexas entre diferentes variáveis.
Não significa que um seja necessariamente melhor.
Eles podem até ser utilizados em conjunto.
Random Forest x Redes Neurais
A comparação com redes neurais também é interessante.
O Random Forest costuma ser mais fácil de interpretar e pode apresentar bom desempenho em bases de dados estruturadas.
Redes neurais podem ser extremamente poderosas quando existem grandes volumes de dados e relações complexas.
Mas novamente:
mais sofisticado não significa automaticamente mais eficiente.
Um modelo simples e bem calibrado pode superar um modelo extremamente complexo.
E o mercado de apostas?
Existe uma questão fundamental:
o mercado já conhece muitas dessas informações.
Se você alimenta o modelo com:
- gols;
- xG;
- posição na tabela;
- desempenho recente;
é possível que parte dessas informações já esteja refletida nas odds.
Por isso, o desafio não é apenas encontrar uma boa previsão.
É encontrar uma previsão que seja melhor ou diferente o suficiente da precificação do mercado.
Um exemplo completo
Imagine uma partida entre Time A e Time B.
O Random Forest produz:
Vitória Time A: 52%
Odd justa:
1 ÷ 0,52 = 1,92
O mercado oferece:
2,10
Agora existe uma diferença entre:
odd justa do modelo = 1,92
e
odd de mercado = 2,10
O modelo identificou um preço potencialmente interessante.
Mas antes de considerar isso uma oportunidade, ainda seria necessário verificar:
- qualidade da estimativa;
- calibração;
- tamanho da amostra;
- desempenho fora da amostra;
- estabilidade do modelo;
- liquidez;
- custos;
- CLV histórico.
Só então a análise começa a ficar realmente robusta.
O que realmente importa?
O Random Forest pode ser excelente para encontrar padrões.
Mas encontrar padrões é apenas uma parte do processo.
O objetivo final é construir uma cadeia consistente:
Dados confiáveis
↓
Variáveis relevantes
↓
Modelo
↓
Probabilidade
↓
Calibração
↓
Odd justa
↓
Comparação com o mercado
↓
EV
↓
Validação fora da amostra
É essa sequência que transforma machine learning em uma ferramenta de análise.
Conclusão
O Random Forest não é uma máquina de prever vencedores.
Ele é uma ferramenta estatística capaz de analisar grandes quantidades de dados e encontrar relações que podem ser difíceis de identificar manualmente.
No futebol, pode ser utilizado para estimar probabilidades de diferentes eventos e, posteriormente, comparar essas estimativas com as odds do mercado.
O ponto central, porém, continua sendo o mesmo:
não basta prever melhor. É preciso precificar melhor.
Uma previsão de 60% só é útil se essa probabilidade for confiável.
E uma probabilidade confiável só ganha relevância quando pode ser comparada com um preço de mercado.
É nessa diferença entre probabilidade estimada e preço oferecido que o Random Forest pode deixar de ser apenas um algoritmo e se tornar uma ferramenta de busca por valor.