Como modelos de inteligência artificial podem transformar dados esportivos em probabilidades — e por que isso não significa prever o futuro
Nos últimos anos, a inteligência artificial passou a ocupar um espaço cada vez maior na análise esportiva. Entre as tecnologias que mais despertam interesse estão as redes neurais, modelos capazes de identificar padrões complexos em grandes conjuntos de dados.
No universo das apostas esportivas, elas podem ser utilizadas para estimar a probabilidade de determinados acontecimentos: vitória de uma equipe, número de gols, ambas as equipes marcarem ou até mesmo a ocorrência de um gol em determinado período da partida.
Mas existe uma diferença fundamental entre estimar probabilidades e prever resultados.
Uma rede neural não sabe quem vai vencer um jogo. Ela tenta encontrar, nos dados disponíveis, padrões que possam melhorar a estimativa sobre o que pode acontecer.
E essa diferença é fundamental para entender como a tecnologia pode ser aplicada aos mercados esportivos.
O que é uma rede neural?
Uma rede neural artificial é um modelo matemático inspirado, de maneira bastante simplificada, no funcionamento das redes de neurônios biológicos.
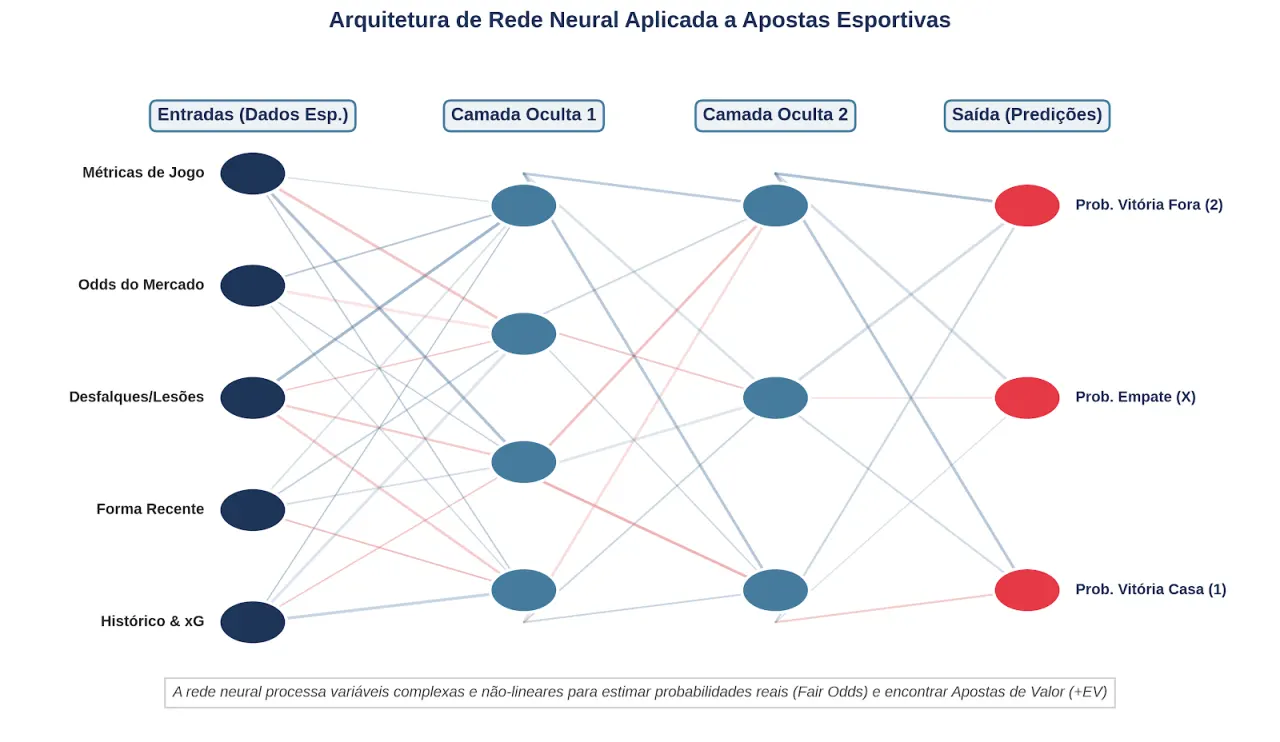
Ela é formada por camadas de unidades de processamento conectadas entre si.
De forma simplificada, podemos imaginar três partes:
Entrada → Processamento → Saída
Na primeira etapa entram os dados utilizados pelo modelo.
No futebol, por exemplo, poderiam ser:
- gols marcados e sofridos;
- xG;
- finalizações;
- desempenho como mandante e visitante;
- forma recente;
- força dos adversários;
- média de gols;
- desempenho defensivo;
- posse de bola;
- cartões;
- desfalques;
- características do campeonato.
Essas informações passam pelas camadas intermediárias da rede, onde o modelo procura identificar relações entre as variáveis.
Finalmente, a rede produz uma saída.
Por exemplo:
Mandante: 52%
Empate: 26%
Visitante: 22%
O resultado não é uma certeza.
É uma estimativa probabilística.
Como a rede aprende?
É aqui que está uma das partes mais interessantes. Uma rede neural precisa ser treinada utilizando dados históricos.
Imagine um banco com milhares de partidas.
Para cada jogo, temos informações disponíveis antes da partida e, posteriormente, sabemos o resultado que realmente aconteceu.
- O modelo recebe os dados de entrada e produz uma previsão.
- Depois, essa previsão é comparada com o resultado real.
- Se o modelo estimou uma probabilidade inadequada, seus parâmetros são ajustados.
- Esse processo acontece repetidamente durante o treinamento.
Em termos simplificados:
Dados históricos → previsão → comparação com o resultado → ajuste → nova previsão
Depois de muitas iterações, a rede procura encontrar uma configuração que minimize seus erros dentro do processo de treinamento.
É importante perceber que ela não está simplesmente “decorando” resultados.
O objetivo é aprender relações existentes nos dados que possam ser utilizadas para produzir novas estimativas.
Um exemplo aplicado ao futebol
Imagine que queremos construir um modelo para estimar a probabilidade de uma equipe vencer uma partida.
Podemos fornecer ao modelo informações como:
Equipe A
- média de 1,8 gol marcado;
- média de 1,0 gol sofrido;
- xG médio de 1,65;
- 65% de aproveitamento em casa.
Equipe B
- média de 1,2 gol marcado;
- média de 1,4 gol sofrido;
- xG médio de 1,20;
- 38% de aproveitamento fora de casa.
Essas informações isoladamente já podem ser utilizadas por diferentes modelos estatísticos.
Uma rede neural, entretanto, pode trabalhar simultaneamente com dezenas ou centenas de variáveis.
Depois de treinada, ela poderia produzir algo como:
P(A vencer) = 54%
Isso não significa que a Equipe A vencerá.
Significa que, segundo o modelo, situações com características semelhantes apresentariam uma probabilidade estimada de vitória de aproximadamente 54%.
Probabilidade é mais importante que o palpite
Essa é provavelmente a ideia mais importante para compreender a aplicação de redes neurais nas apostas esportivas.
Imagine que um modelo estime:
Probabilidade de vitória = 54%
A partir dessa probabilidade, podemos calcular uma odd justa:
Odd justa = 1 ÷ 0,54
Odd justa ≈ 1,85
Essa é uma simplificação matemática importante.
O modelo não está dizendo:
“A equipe vai vencer.”
Ele está dizendo:
“Minha estimativa é que esse evento aconteça em aproximadamente 54% das vezes.”
A partir daí, a análise passa a envolver a comparação entre a probabilidade estimada pelo modelo e a probabilidade implícita na cotação disponível no mercado.
É nesse ponto que conceitos como valor esperado (EV) entram na discussão.
Redes neurais conseguem encontrar padrões que outros modelos não encontram?
Podem! E essa é uma das principais razões para seu uso.
Modelos estatísticos tradicionais, como a regressão logística ou modelos baseados em Poisson, podem ser extremamente úteis no futebol.
A vantagem potencial das redes neurais está na capacidade de modelar relações não lineares e interações complexas entre variáveis.
Por exemplo, uma determinada estatística pode ter um impacto diferente dependendo de outra variável.
- O efeito de jogar em casa pode não ser igual para todas as equipes.
- O desempenho de um atacante pode depender do estilo de jogo da equipe.
- A quantidade de finalizações pode ter significados diferentes dependendo da qualidade das chances.
Uma rede neural pode tentar aprender essas relações diretamente a partir dos dados.
Mas isso não significa automaticamente que ela será melhor.
E esse é um dos maiores erros na discussão sobre inteligência artificial aplicada às apostas.
O perigo do overfitting
Imagine que você tenha 10 mil partidas históricas.
Você treina uma rede neural e consegue resultados excelentes nesses dados.
Isso parece fantástico.
Mas existe uma pergunta muito mais importante:
Como o modelo se comporta em partidas que ele nunca viu?
Se ele apresentar desempenho muito inferior, podemos estar diante do chamado overfitting.
O modelo aprendeu tão bem as características específicas dos dados utilizados no treinamento que perdeu capacidade de generalização.
É como um aluno que decora as respostas de uma prova, mas não aprendeu realmente o conteúdo.
No futebol, esse problema pode ser particularmente perigoso.
Uma estratégia pode parecer excepcionalmente lucrativa no histórico simplesmente porque o modelo capturou ruídos, peculiaridades ou coincidências daquele conjunto de partidas.
Por isso, um modelo não deve ser avaliado apenas pelo resultado obtido nos dados utilizados para treiná-lo.
Treinamento, validação e teste
Uma abordagem mais adequada é separar os dados.
Uma estrutura simplificada poderia ser:
Dados de treinamento → desenvolvimento do modelo
Dados de validação → escolha e ajuste do modelo
Dados de teste → avaliação final
No futebol, existe ainda um cuidado adicional: o tempo importa.
Não faria sentido utilizar informações futuras para construir uma previsão que supostamente seria feita no passado.
Por isso, uma avaliação temporal pode ser muito mais adequada.
Por exemplo:
2019–2023: treinamento
2024: validação
2025: teste
Dessa forma, o modelo é avaliado em um período posterior àquele utilizado para aprender.
É uma forma mais próxima da situação real.
E se a rede neural acertar muito?
Mesmo uma taxa de acerto elevada não prova que existe uma vantagem sustentável.
Imagine um modelo que acerte 60% das previsões.
Parece excelente.
Mas precisamos saber:
- quais mercados foram utilizados;
- quais eram as odds;
- quantos jogos foram analisados;
- qual foi o retorno financeiro;
- qual foi o nível de variância;
- como o modelo se comportou fora da amostra;
- se houve mudanças nas ligas e nos mercados;
- se os resultados permaneceram estáveis em diferentes períodos.
Uma taxa de acerto isolada diz muito pouco.
Em mercados esportivos, probabilidade, preço e desempenho fora da amostra precisam ser analisados conjuntamente.
Redes neurais não eliminam a incerteza
Esse talvez seja o maior ponto de confusão.
Uma rede neural sofisticada continua trabalhando com um esporte extremamente imprevisível.
- Uma bola desviada.
- Um cartão vermelho.
- Uma lesão.
- Um pênalti.
- Uma falha individual.
- Uma decisão de arbitragem.
Todos esses acontecimentos podem alterar completamente uma partida.
A inteligência artificial não elimina esses eventos.
Ela tenta estimar, com base nas informações disponíveis, como eles se encaixam dentro de um cenário probabilístico.
Portanto, quanto mais sofisticado o modelo, não necessariamente menor será a incerteza.
O que pode melhorar é a qualidade da estimativa.
Redes neurais versus modelos estatísticos
Não existe uma regra dizendo que inteligência artificial sempre supera estatística tradicional.
Um modelo relativamente simples pode produzir resultados melhores do que uma rede neural complexa, especialmente quando o conjunto de dados é pequeno ou quando as variáveis disponíveis não carregam informação suficiente.
Por isso, uma boa análise pode comparar diferentes abordagens:
Regressão logística
Boa para problemas de classificação e interpretação das relações entre variáveis.
Poisson
Muito utilizada na modelagem de gols no futebol.
Árvores de decisão e modelos de ensemble
Podem capturar relações não lineares e interações entre variáveis.
Redes neurais
Podem trabalhar com relações altamente complexas e grandes quantidades de variáveis.
O objetivo não deveria ser escolher o modelo mais sofisticado.
Deveria ser descobrir qual modelo produz estimativas mais confiáveis e generalizáveis para determinado problema.
O verdadeiro desafio: calibrar probabilidades
Existe uma diferença entre acertar previsões e produzir boas probabilidades.
Imagine dois modelos.
O primeiro diz:
Jogo 1: 90%
Jogo 2: 90%
Jogo 3: 90%
Ele pode acertar alguns jogos, mas isso não significa necessariamente que suas probabilidades sejam confiáveis.
Um modelo bem calibrado deveria apresentar uma relação consistente entre suas probabilidades previstas e a frequência observada.
Se ele prevê aproximadamente 70% de probabilidade para centenas de eventos, esperamos que algo próximo de 70% deles realmente aconteça.
Esse conceito é extremamente importante quando o objetivo é transformar previsões em decisões baseadas em valor.
A rede neural como ferramenta, não como oráculo
É tentador imaginar a inteligência artificial como uma espécie de máquina capaz de descobrir “a aposta certa”.
Essa visão é problemática.
Uma rede neural é uma ferramenta estatística.
Ela depende:
- da qualidade dos dados;
- das variáveis escolhidas;
- da metodologia de treinamento;
- da quantidade de observações;
- da forma como o modelo é validado;
- da estabilidade dos padrões;
- e da qualidade da avaliação fora da amostra.
Um modelo sofisticado alimentado por dados ruins continuará produzindo resultados ruins.
Em outras palavras:
IA não transforma dados ruins em informação boa.
Ela pode apenas processar os dados de uma maneira mais complexa.
Onde está o valor?
A grande contribuição das redes neurais para as apostas esportivas talvez não esteja em “adivinhar resultados”.
Está em tentar responder uma pergunta muito mais interessante:
Podemos estimar probabilidades melhores do que as disponíveis no mercado?
Se a resposta for sim, surge uma possibilidade de estudar discrepâncias entre a probabilidade estimada e o preço oferecido.
Mas essa diferença precisa ser persistente.
Uma discrepância encontrada em dez jogos pode ser apenas ruído.
Uma diferença observada em milhares de observações, validada fora da amostra e acompanhada por boa calibração, passa a ser muito mais interessante do ponto de vista estatístico.
É justamente aí que a análise deixa de ser simplesmente uma busca por palpites e passa a se aproximar de um problema de modelagem probabilística.
O próximo passo
Redes neurais são apenas uma parte do universo de modelos que podem ser utilizados na análise esportiva.
A partir daqui, é possível avançar para questões ainda mais interessantes:
Como escolher as variáveis?
Quantos jogos são necessários para treinar um modelo?
Como evitar overfitting?
Como fazer backtesting corretamente?
Como medir a calibração de um modelo?
É melhor utilizar uma rede neural ou um modelo de Poisson?
Modelos diferentes podem ser combinados?
Essas perguntas são, muitas vezes, mais importantes do que simplesmente perguntar qual modelo “acerta mais”.
Conclusão
As redes neurais podem transformar grandes volumes de dados esportivos em estimativas probabilísticas sofisticadas.
Mas sua utilização nas apostas esportivas não deve ser confundida com previsão infalível.
O objetivo não é descobrir o resultado de uma partida antes que ela aconteça.
É construir um modelo capaz de estimar probabilidades de maneira consistente, testar essas estimativas em dados que o modelo nunca viu e verificar se existe alguma relação entre probabilidade estimada e preço de mercado.
No fim, a inteligência artificial não elimina a incerteza do esporte.
Ela apenas oferece mais uma ferramenta para tentar medi-la.
E, quando falamos de apostas esportivas como um problema de análise de dados, talvez essa seja justamente a pergunta mais importante:
não é quem vai ganhar — é quão boa é a nossa estimativa sobre a chance de cada resultado acontecer.