Da coleta de dados ao modelo probabilístico: como o aprendizado de máquina pode ser aplicado à análise dos mercados esportivos
Falar em Machine Learning nas apostas esportivas costuma despertar uma imagem bastante sedutora: colocar milhares de jogos em um computador, deixar um algoritmo procurar padrões e esperar que ele descubra onde está o próximo grande valor.
Na prática, o processo é muito mais interessante — e também muito mais complexo.
Machine Learning, ou aprendizado de máquina, não é uma fórmula mágica para prever resultados.
É um conjunto de técnicas que permite construir modelos capazes de aprender relações a partir de dados históricos e utilizar esse aprendizado para produzir estimativas sobre novos eventos.
No futebol, isso pode significar transformar informações sobre equipes, jogadores, gols, xG, finalizações, mando de campo e desempenho recente em uma estimativa de probabilidade.
A questão central deixa de ser:
“Quem vai ganhar?”
E passa a ser:
“Como podemos transformar dados históricos em um modelo capaz de estimar probabilidades para jogos que ainda não aconteceram?”
O que é Machine Learning?
Machine Learning é uma área da inteligência artificial na qual algoritmos são utilizados para identificar padrões em dados e melhorar seu desempenho em determinada tarefa.
A ideia básica pode ser representada assim:
Dados → Algoritmo → Aprendizado → Modelo → Nova previsão
Imagine uma base com milhares de partidas de futebol.
Para cada jogo, podemos ter informações como:
- gols marcados;
- gols sofridos;
- xG;
- finalizações;
- finalizações no alvo;
- posse de bola;
- desempenho em casa;
- desempenho fora;
- posição na tabela;
- força dos adversários;
- sequência recente de resultados;
- cartões;
- desfalques;
- características da competição.
Além dessas variáveis, temos aquilo que queremos tentar estimar.
Por exemplo:
A equipe mandante venceu?
O algoritmo procura relações entre as variáveis de entrada e o resultado observado.
Depois de treinado, o modelo pode receber os dados de uma nova partida e produzir uma estimativa.
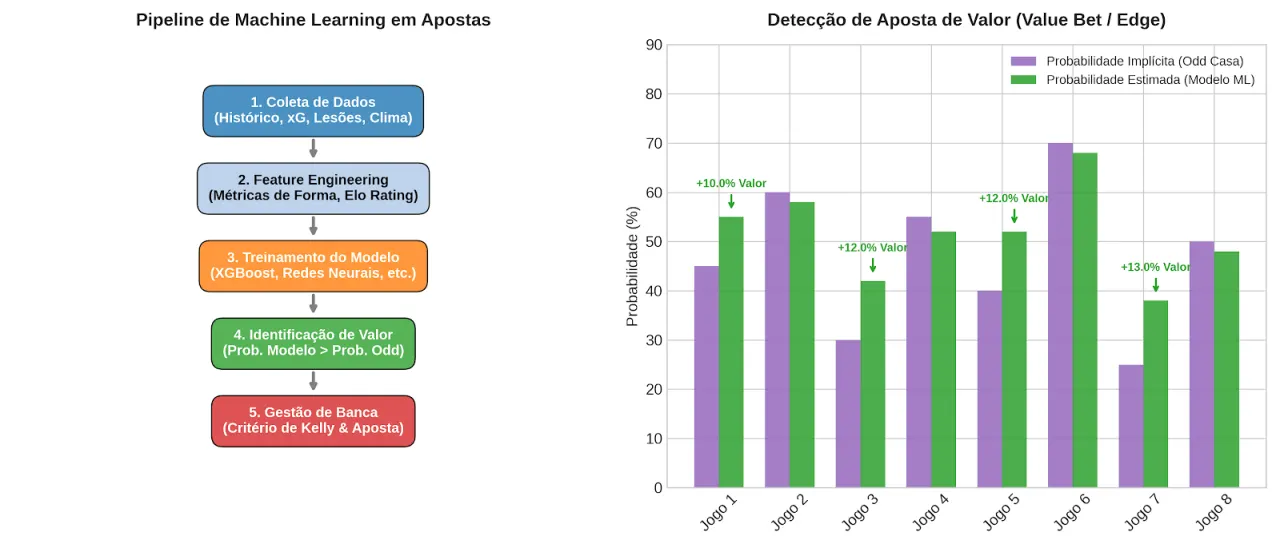
O primeiro passo é definir o problema
Antes de escolher um algoritmo, existe uma pergunta muito mais importante:
O que exatamente queremos prever?
Essa decisão determina praticamente todo o projeto.
Podemos tentar estimar:
Resultado da partida
- vitória do mandante;
- empate;
- vitória do visitante.
Mercados de gols
- Over 0.5;
- Over 1.5;
- Over 2.5;
- Under 2.5.
Ambas marcam
Eventos durante a partida
- gol até determinado minuto;
- próximo gol;
- gol no segundo tempo.
Cada problema exige uma abordagem diferente.
Por isso, construir um modelo começa muito antes do algoritmo.
Começa com uma pergunta bem definida.
Transformando partidas em dados
Uma partida de futebol é um evento complexo. Um algoritmo, entretanto, não entende diretamente conceitos como “time forte”, “momento ruim” ou “defesa vulnerável”.
Precisamos transformar essas características em variáveis numéricas.
Imagine uma tabela:
| Jogo | Mandante | Visitante | xG Casa | xG Fora | Gols Casa | Gols Fora | Resultado |
|---|
| 1 | A | B | 1,82 | 0,91 | 2 | 0 | Casa |
| 2 | C | D | 1,21 | 1,47 | 1 | 2 | Fora |
| 3 | E | F | 1,65 | 1,10 | 1 | 1 | Empate |
Essa tabela é apenas uma representação simplificada.
Na prática, podemos trabalhar com dezenas ou centenas de variáveis.
O desafio passa a ser descobrir:
quais informações realmente ajudam o modelo?
Feature Engineering: transformar informação em sinal
Um dos conceitos mais importantes em Machine Learning é o feature engineering.
Features são as variáveis utilizadas pelo modelo.
Imagine que temos apenas:
Gols marcados nos últimos cinco jogos.
Podemos transformar isso em:
- média de gols;
- mediana;
- maior número de gols;
- menor número de gols;
- tendência recente;
- gols em casa;
- gols fora.
Também podemos criar diferenças entre as equipes.
Por exemplo:
xG do mandante − xG do visitante
Ou:
média de gols marcados pelo mandante em casa − média de gols sofridos pelo visitante fora
Essas novas variáveis podem fornecer ao algoritmo informações mais relevantes.
É por isso que construir um bom modelo não significa simplesmente jogar o máximo de dados possível dentro de um algoritmo.
É necessário pensar sobre como os dados representam o problema.
O cuidado mais importante: não usar o futuro
Existe um erro particularmente perigoso em modelos esportivos:
vazamento de informação, ou data leakage.
Imagine que queremos prever uma partida que aconteceu em março.
Se utilizarmos a média de gols da equipe durante toda a temporada, podemos estar incluindo partidas que aconteceram depois daquele jogo.
Isso significa que o modelo recebeu informações que não estavam disponíveis no momento da previsão.
O resultado pode parecer excelente.
Mas é artificial.
Em uma aplicação real, o modelo só poderia utilizar informações disponíveis até aquele momento.
Esse cuidado é fundamental.
Uma regra simples ajuda:
Para prever o futuro, o modelo nunca pode enxergar o futuro.
Treinando o modelo
Depois de organizar os dados, podemos dividir nossa base.
Uma estrutura simplificada seria:
Treinamento: 70%
Validação: 15%
Teste: 15%
Os dados de treinamento são utilizados para que o algoritmo aprenda.
Os dados de validação ajudam a escolher parâmetros e comparar versões do modelo.
Finalmente, os dados de teste servem para avaliar como o modelo se comporta em dados que não participaram do processo de construção.
No futebol, porém, existe uma particularidade.
Os jogos acontecem em ordem cronológica.
Por isso, uma divisão temporal pode ser ainda mais adequada.
Por exemplo:
2019–2023 → treinamento
2024 → validação
2025 → teste
O modelo aprende com o passado e é avaliado em períodos posteriores.
Isso se aproxima muito mais da utilização real.
Qual algoritmo utilizar?
Não existe um único algoritmo ideal para apostas esportivas.
Algumas possibilidades são:
Regressão logística
É uma das opções mais interessantes para problemas de classificação.
Pode estimar, por exemplo, a probabilidade de uma equipe vencer.
Sua principal vantagem é a simplicidade e a possibilidade de interpretar melhor a relação entre as variáveis.
Árvores de decisão
Criam estruturas semelhantes a decisões condicionais.
Por exemplo:
xG > determinado valor?
Sim → caminho A
Não → caminho B
Elas conseguem capturar relações não lineares.
Random Forest
Combina diversas árvores de decisão.
A ideia é produzir um modelo mais robusto do que uma árvore isolada.
Gradient Boosting
Métodos como Gradient Boosting e XGBoost são bastante utilizados em problemas tabulares.
Eles constroem modelos sequencialmente, tentando corrigir erros cometidos anteriormente.
Redes neurais
Podem trabalhar com relações complexas entre muitas variáveis.
São especialmente interessantes quando existe grande quantidade de dados e características relevantes.
Mas mais complexidade não significa automaticamente mais precisão.
O modelo precisa produzir probabilidades
Esse ponto é fundamental para aplicações em mercados esportivos.
Imagine que o modelo diga:
Vitória do mandante: 57%
Isso é muito mais informativo do que simplesmente:
Mandante vence.
A primeira informação permite calcular uma probabilidade implícita e compará-la com o preço do mercado.
A odd justa simplificada seria:
1 ÷ 0,57 = 1,75
Se o mercado estiver oferecendo uma cotação diferente, podemos investigar a relação entre a estimativa do modelo e o preço.
É aqui que Machine Learning pode se conectar com conceitos como probabilidade implícita, odd justa, Edge e Expected Value.
O algoritmo não precisa necessariamente “acertar o vencedor”.
Ele precisa produzir estimativas probabilísticas suficientemente boas.
Acerto não é tudo
Imagine dois modelos.
Modelo A
Acerta 65% dos jogos.
Modelo B
Acerta 58%.
À primeira vista, o Modelo A parece claramente superior.
Mas agora imagine que o Modelo A faça previsões extremamente concentradas em eventos com odds baixas, enquanto o Modelo B consiga identificar probabilidades mais bem calibradas em diferentes faixas de preço.
A comparação muda.
Por isso, uma análise séria precisa olhar para outras métricas.
Entre elas:
- Log Loss;
- Brier Score;
- acurácia;
- precisão;
- recall;
- calibração;
- ROI;
- retorno por unidade;
- estabilidade temporal.
Cada métrica responde a uma pergunta diferente.
Calibração: o modelo está dizendo a verdade sobre suas probabilidades?
Imagine que um modelo faça 1.000 previsões com probabilidade de 70%.
Se ele estiver bem calibrado, aproximadamente 70% desses eventos deveriam acontecer.
Não significa que exatamente 700 acontecerão.
Existe variância.
Mas, em uma amostra suficientemente grande, esperamos que a frequência observada se aproxime da probabilidade prevista.
Esse é o conceito de calibração.
Um modelo pode ter uma boa taxa de acerto e ser mal calibrado.
E isso é particularmente importante quando trabalhamos com probabilidades.
Afinal, não queremos apenas saber se o modelo acertou.
Queremos saber se:
60% realmente significa algo próximo de 60%.
O problema do overfitting
Quanto mais complexo o modelo, maior pode ser o risco de overfitting.
Imagine um algoritmo que encontre uma relação extremamente específica nos dados históricos.
Talvez determinado campeonato tenha apresentado uma sequência incomum de resultados.
Talvez uma equipe tenha passado por uma temporada atípica.
Talvez determinada variável tenha se correlacionado com os resultados apenas por acaso.
O modelo pode aprender esse padrão.
No histórico, ele funciona muito bem.
Quando encontra novos jogos, porém, seu desempenho desaparece.
É por isso que o resultado do treinamento não deve ser confundido com capacidade de previsão.
O objetivo do Machine Learning é generalizar.
Ou seja:
aprender padrões que continuem úteis quando surgirem dados novos.
Backtesting não é garantia de resultado futuro
Depois de construir um modelo, podemos realizar um backtest.
A ideia é simular como ele teria se comportado em períodos históricos.
Isso pode ser extremamente útil.
Mas existe uma armadilha.
Se testarmos dezenas ou centenas de estratégias até encontrar uma que funcionou muito bem no passado, podemos acabar encontrando simplesmente a estratégia que melhor se ajustou àquele histórico.
Esse processo é conhecido como data snooping ou múltipla exploração dos dados.
Quanto mais tentativas fazemos sobre o mesmo conjunto de dados, maior a possibilidade de encontrar resultados aparentemente significativos por acaso.
Por isso, um conjunto de dados realmente reservado para teste é tão importante.
Machine Learning não substitui conhecimento esportivo
Existe uma ideia equivocada de que, depois de construído o modelo, o analista deixa de ser necessário.
Não é assim.
O modelo depende de decisões humanas.
Alguém precisa decidir:
- qual problema será estudado;
- quais dados serão coletados;
- quais variáveis serão utilizadas;
- como tratar dados ausentes;
- como dividir treinamento e teste;
- quais métricas utilizar;
- como interpretar os resultados;
- como identificar possíveis vieses.
O algoritmo aprende padrões.
Mas quem constrói o experimento precisa determinar o que será aprendido e como será avaliado.
Um exemplo de projeto do zero
Imagine que queremos criar um modelo para estimar a probabilidade de Over 0.5 gol no primeiro tempo.
Podemos começar com milhares de partidas históricas.
Para cada partida, coletamos informações que estavam disponíveis antes do início do jogo.
Por exemplo:
- média de gols no primeiro tempo do mandante;
- média de gols no primeiro tempo do visitante;
- frequência histórica de Over 0.5 HT;
- xG das equipes;
- gols marcados recentemente;
- gols sofridos recentemente;
- desempenho como mandante;
- desempenho como visitante;
- força dos adversários;
- média da competição.
O algoritmo recebe essas variáveis.
O alvo é:
1 = houve gol no primeiro tempo
0 = não houve gol no primeiro tempo
Depois do treinamento, o modelo poderia produzir:
P(Over 0.5 HT) = 72%
A partir daí, podemos comparar essa estimativa com outras referências.
Por exemplo:
Probabilidade histórica da liga
Probabilidade de um modelo estatístico
Probabilidade implícita no mercado
Probabilidade produzida pelo Machine Learning
A questão deixa de ser “o algoritmo acertou este jogo?”
Passa a ser:
As probabilidades produzidas pelo modelo são melhores do que as alternativas quando avaliadas em dados novos?
Essa é uma pergunta muito mais interessante.
Machine Learning + modelos estatísticos
Não precisamos escolher entre estatística e Machine Learning.
Podemos combinar as abordagens.
Um modelo de Poisson pode fornecer uma estimativa de gols.
Uma regressão logística pode estimar determinado resultado.
Um modelo de Gradient Boosting pode trabalhar com dezenas de variáveis adicionais.
Uma rede neural pode encontrar relações mais complexas.
Podemos então comparar os modelos ou até combiná-los.
Esse tipo de abordagem é conhecido como ensemble modeling.
A ideia é simples:
modelos diferentes podem enxergar partes diferentes do problema.
Se suas previsões forem complementares, uma combinação pode produzir estimativas mais robustas.
Onde está a verdadeira dificuldade?
O maior desafio provavelmente não está em escolher entre Random Forest, XGBoost ou uma rede neural.
Está nos dados.
Um modelo sofisticado não consegue compensar completamente:
- dados incompletos;
- informações inconsistentes;
- amostras pequenas;
- variáveis mal definidas;
- vazamento de informação;
- mudanças estruturais no futebol;
- problemas de seleção da amostra;
- overfitting.
Existe uma frase bastante conhecida na ciência de dados:
“Garbage in, garbage out.”
Se os dados de entrada forem ruins, o resultado também tende a ser ruim.
Por isso, antes de procurar o algoritmo mais sofisticado, é necessário construir uma base de dados confiável.
O futuro não precisa se parecer com o passado
Esse é outro problema importante.
O futebol muda.
Técnicos mudam.
Regras mudam.
Estilos de jogo mudam.
Calendários mudam.
Jogadores mudam.
O próprio mercado de apostas muda.
Um padrão que existia cinco anos atrás pode não existir mais.
Isso significa que um modelo precisa ser monitorado continuamente.
Não basta treiná-lo uma vez e assumir que ele continuará funcionando indefinidamente.
Modelos esportivos precisam ser testados, recalibrados e reavaliados.
Então, Machine Learning funciona nas apostas esportivas?
A resposta mais correta é:
pode funcionar, mas isso precisa ser demonstrado pelos dados.
Não existe algoritmo que garanta lucro.
O objetivo de um projeto sério não deveria ser encontrar uma máquina que “acerte apostas”.
Deveria ser construir um sistema capaz de:
- coletar dados confiáveis;
- transformar esses dados em variáveis relevantes;
- treinar modelos;
- produzir probabilidades;
- testar essas probabilidades fora da amostra;
- medir sua calibração;
- comparar diferentes modelos;
- avaliar estabilidade ao longo do tempo;
- comparar as estimativas com o mercado;
- verificar se qualquer vantagem observada é persistente.
Essa última etapa é crucial.
Uma vantagem estatística precisa sobreviver ao teste.
Do dado ao modelo
Podemos resumir todo o processo em uma sequência:
1. Pergunta
O que queremos estimar?
↓
2. Dados
Quais informações podem ajudar?
↓
3. Features
Como transformar essas informações em variáveis?
↓
4. Treinamento
Qual algoritmo consegue aprender os padrões?
↓
5. Validação
O modelo funciona em dados que não utilizou para aprender?
↓
6. Teste
Como ele se comporta em um período realmente separado?
↓
7. Probabilidade
As previsões são bem calibradas?
↓
8. Mercado
Como essas probabilidades se relacionam com os preços disponíveis?
↓
9. Monitoramento
O modelo continua funcionando quando surgem novos dados?
Essa sequência é muito mais importante do que simplesmente escolher um algoritmo famoso.
Conclusão
Machine Learning pode ser uma ferramenta poderosa para análise de apostas esportivas porque permite transformar grandes volumes de dados em modelos capazes de produzir estimativas probabilísticas.
Mas o algoritmo é apenas uma parte do processo.
A qualidade dos dados, a escolha das variáveis, a construção da amostra, a prevenção de vazamento de informação, o controle do overfitting e principalmente a validação fora da amostra são fundamentais.
No fim, a pergunta mais interessante não é:
“Qual algoritmo ganha mais?”
É:
“Qual modelo consegue produzir probabilidades mais confiáveis quando enfrenta dados que nunca viu?”
Essa mudança de perspectiva é importante.
Porque apostas esportivas, quando analisadas por uma perspectiva quantitativa, não precisam ser tratadas como um exercício de adivinhação.
Podem ser estudadas como um problema de probabilidade, modelagem, dados e tomada de decisão sob incerteza.
E é justamente nesse espaço que o Machine Learning se torna uma ferramenta interessante para o laboratório de análise esportiva.